Новая модель DeepSeek догоняет Claude и GPT за копейки, но слишком часто выдумывает факты

DeepSeek обновила открытую модель V4.1 Flash до ревизии 1017. Формально это небольшой апдейт, но на деле разработчик заметно поднял эффективность нейросети. На странице релиза модель продвигают слоганом "программирование по желанию стало реальностью". Это явный намёк на популярное понятие "вайбкодинг" – модель позиционируют как инструмент для открытых задач, описанных в общих чертах.
Но у низкой цены и высоких результатов в тестах есть обратная сторона. DeepSeek V4.1 Flash 1017 (DSF-1017) заметно чаще конкурентов из закрытого сегмента выдаёт галлюцинации – уверенно сообщает выдуманную информацию.
Рынок больших языковых моделей сегодня делится на два лагеря.
С одной стороны – закрытые коммерческие разработки ведущих лабораторий: запускать их дорого, зато результат стабильно высокий.
С другой – китайские модели с открытыми весами, которые жертвуют частью надёжности ради намного более низкой стоимости работы, особенно в длительных агентных сценариях.
DSF-1017 построена на архитектуре Mixture-of-Experts (MoE, "смесь экспертов"). Всего у модели 552 миллиарда параметров, но при обработке каждого запроса работают лишь 16 миллиардов. Такой подход сохраняет "знания" крупной модели и при этом заметно экономит вычислительные ресурсы. Нейросеть мультимодальная, принимает на вход текст и изображения, а её контекстное окно достигает ставшего стандартом 1 миллиона токенов.
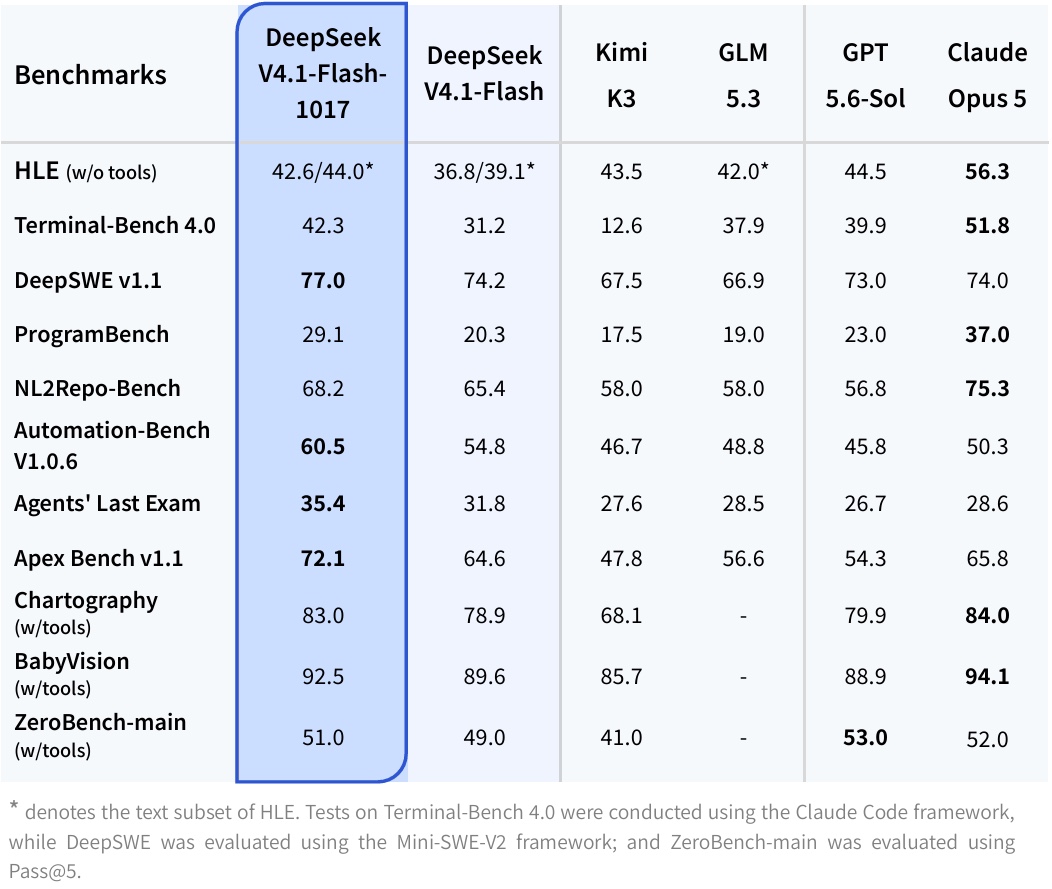
По внутренним тестам DeepSeek, модель располагается между GPT-5.6 Sol и Claude Opus 5, причём в задачах агентного типа она обходит разработку Anthropic. Главное достижение ревизии – эффективность на одну задачу и расход токенов. По сравнению с V4 Flash новая версия использует для KV-кэша вчетверо меньше памяти HBM и в восемь раз меньше места на SSD, а одна запись на токен занимает всего 890 байт.
KV-кэш хранит промежуточные данные механизма внимания для уже обработанного контекста. Чем длиннее диалог или агентная сессия, тем больше места он занимает. Сокращение его объёма напрямую снижает требования к дорогой видеопамяти и позволяет обслуживать больше запросов на том же оборудовании.
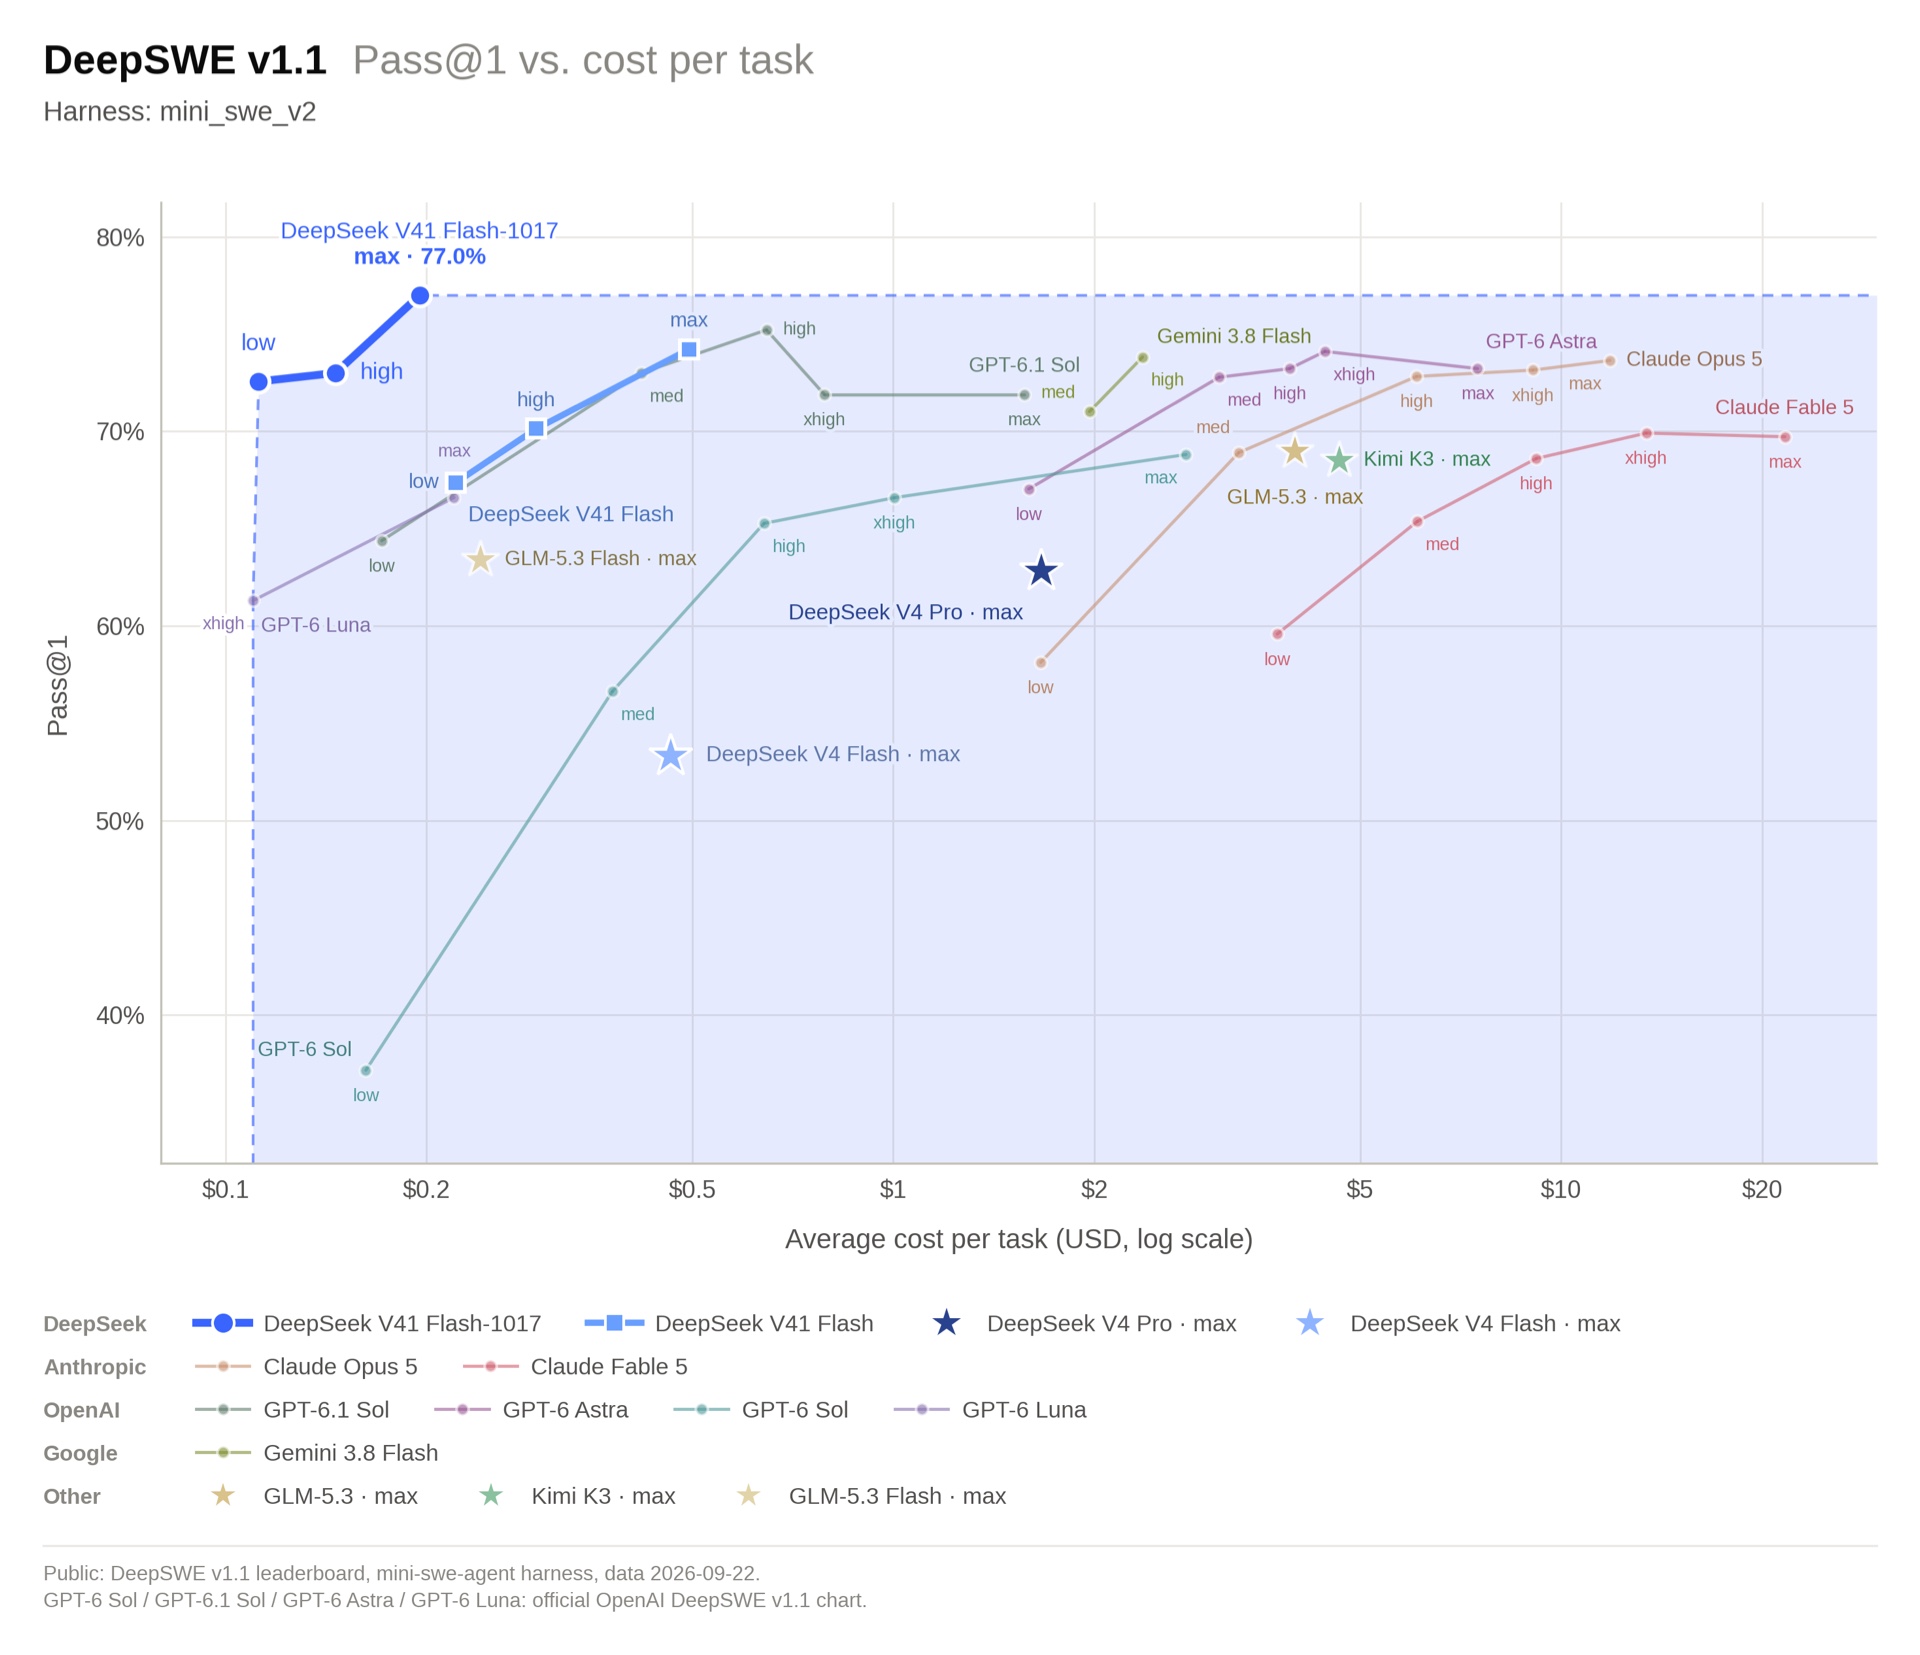
Для наглядности DeepSeek опубликовала график стоимости выполнения задачи на основе датасета DeepSWE от 2 сентября и добавила туда собственные результаты для DSF и DSF-1017. Обе версии оказались в верхнем левом углу графика, где сочетаются высокая доля решённых задач и низкая цена. Даже в режиме минимальных усилий DSF-1017 показывает процент выполнения, сопоставимый с максимальными настройками дорогих конкурентов. DeepSWE – лишь один из многих бенчмарков, но результат всё равно впечатляет.
Модель распространяется с открытыми весами, так что её можно запустить на любой инфраструктуре. При этом даже официальные тарифы DeepSeek в часы низкой нагрузки выглядят очень скромно:
$0.15 за миллион входных токенов
$0.6 за миллион выходных токенов
$0.003 за миллион входных токенов при попадании в кэш
$0.75 за 1 000 поисковых запросов
Поиск стоит меньше, чем у конкурентов – ближайший из них, Parallel, берёт $1 за тот же объём. Сторонние провайдеры инференса уже не раз предлагали модели DeepSeek дешевле официального API, так что итоговая цена может оказаться ещё ниже.
Независимая аналитическая платформа Artificial Analysis ставит DSF-1017 в режиме max на второе место в своём индексе интеллекта среди крупных открытых моделей. Модель набрала 45 баллов, а лидер общего рейтинга, Claude Opus 5.5 в режиме max с резервным переключением, получил 58. Кроме того, DSF-1017 входит в число самых быстрых моделей своего класса, а по стоимости выполнения задачи её опережает только MiMo V2.6-Pro от Xiaomi.
Проблемы начинаются там, где модель должна понимать границы собственных знаний. Пользователи обычно предпочитают нейросети, которые отказываются отвечать при нехватке подтверждённых фактов. DSF-1017 с этим справляется плохо.
В бенчмарке Omniscience от Artificial Analysis модель оказалась среди худших. Правильные ответы она дала в 43% случаев – это один из лучших показателей среди открытых моделей, но закрытые конкуренты всё равно выше. Само по себе это не проблема, если при отсутствии знаний модель честно пропускает вопрос. Однако в 67% таких ситуаций она выдумывала ответ.
Основной индекс Omniscience начисляет баллы за верные ответы и снимает их за ошибочные, а отказы от ответа не учитываются. DSF-1017 получила всего 5 баллов, у Kimi K3-max их 20, а у ведущих закрытых моделей от 42 и выше. Это не значит, что модель некомпетентна – скорее наоборот. Просто задачи для неё стоит подбирать осмотрительно.
Лучше всего DSF-1017 подходит для работы, результат которой можно автоматически проверить:
программирование
распознавание текста (OCR) с последующей проверкой
конвертация форматов данных
В таких сценариях агент может прогнать проверку собственной работы и при ошибке попробовать снова. А вот открытые исследования, поиск фактов, а также интерпретацию и составление документов, где важна точность формулировок, разумнее доверить закрытым моделям или человеку. Галлюцинации в этих задачах сложно отловить, и надёжность результата будет невысокой.
Похожая картина складывается и у других сильных открытых моделей. Несколько месяцев назад Moonshot AI выпустила Kimi K3, которую хвалили за эффективность и низкую цену при интеллекте почти на уровне закрытых лидеров. Но и она нередко выдаёт выдуманные данные даже при коротких и точных запросах на поиск фактов – это подтверждают показатели Artificial Analysis.

"Крестный отец ИИ" Джеффри Хинтон считает нейросети сознательными и предупреждает, что людям может прийти "конец"

Владелец телевизора Samsung использовал ИИ Claude и за 11 часов очистил телевизор от рекламы и слежки
При этом открытые модели сохраняют важную роль на рынке. Они делают ИИ-агентов доступнее в абсолютных цифрах и сдерживают стоимость вычислений на фоне возможного подорожания услуг ведущих лабораторий.
- Министерство внутренней безопасности США запретило правительству использовать китайский ИИ DeepSeek
- Инженер DeepSeek объяснил, почему создает ИИ, который заменит его самого – чтобы мир не стал похож на Cyberpunk 2077
- Часы пик DeepSeek выдали географию пользователей
Об авторе