Взломанная PS4 запустила ИИ-модель на 9 миллиардов параметров со скоростью до 43 токенов в секунду

Леонардо Алегрия выложил в открытый доступ Garlic LLM – приложение для взломанной PlayStation 4. Оно запускает языковую модель Qwen3.5-9B от Alibaba с 9 миллиардами параметров целиком офлайн, прямо на GPU консоли 2013 года.
Программа общается с видеочипом напрямую, минуя драйверы. Модель сжата и выдаёт от 31 до 39 токенов в секунду.
Название проекта отсылает к типу памяти, которую GPU консоли читает напрямую. В архитектуре PS4 она называется Garlic, а "родственный" ей тип памяти получил имя Onion.
Чтобы Garlic LLM заработал, нужна взломанная PS4 с установленным GoldHEN – инструментом для запуска хоумбрю-программ. Приложение бесплатное и качается одним пакетом на 5,66 ГБ с Hugging Face, ставится штатным Package Installer. Понадобится около 6 ГБ свободного места, а если сначала скопировать пакет на внутренний диск консоли – все 12.
Garlic LLM умеет не только текстовый чат, но и голосовой диалог. Ответы озвучиваются на семи языках через речевую модель Chatterbox, правда скорость языковой модели в этом режиме падает примерно до 22 токенов в секунду. Если зажать кнопку на контроллере, включается диктовка, а речь распознаёт модель Parakeet TDT 0.6B v3 от Nvidia с поддержкой 25 европейских языков.
Модели семейства Parakeet стоят и в локальных приложениях для транскрибации и диктовки вроде Meetily и Hex. Основная же здесь – компактная Qwen3.5-9B с открытыми весами. Автор заявляет 31–39 токенов в секунду в текстовом чате, но промпт и методику тестирования не приводит.
Ближайший аналог – форк PS5LM для PlayStation 5. Он запускает llama.cpp как нативное приложение и добирается до GPU от AMD через PS5_Vulkan, порт драйвера RADV. Сама llama.cpp – популярный открытый инструмент для локального запуска языковых моделей, а RADV позволяет видеокартам AMD работать с Vulkan, графическим и вычислительным API.
На PS4 такого драйверного слоя для хоумбрю просто нет. По всей видимости, Garlic LLM обходится без llama.cpp и без порта Vulkan, решая задачу собственными средствами.
Все операции модели, включая перемножение матриц с 4-битными весами, оформлены как вычислительные ядра на OpenCL C. Их компилирует LLVM под AMD Graphics Core Next (GCN) – архитектуру, на которой построен GPU консоли. Веса лежат в памяти Garlic, а на стороне CPU код на чистом C ведёт токенизатор, интерфейс, отрисовку текста и звук.
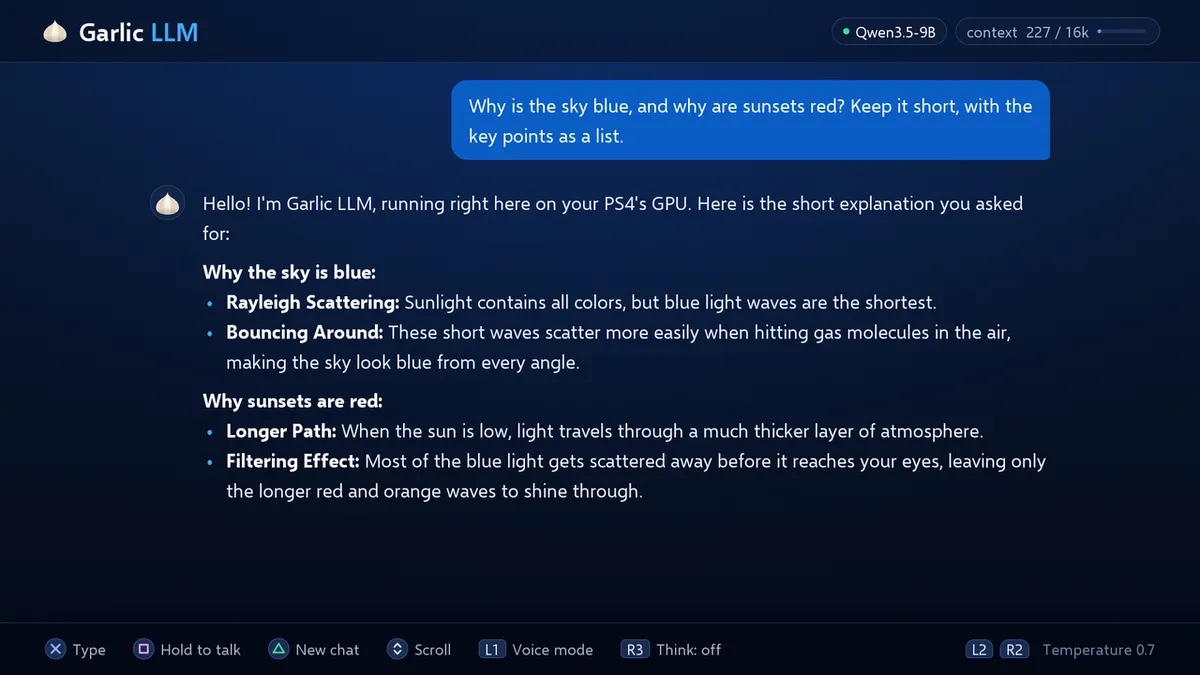
Как всё это работает:
Промпт сначала идёт в токенизатор на процессоре. Для каждого токена формируется командный буфер PM4 с низкоуровневыми инструкциями – обычно их генерирует графический драйвер, но здесь приложение собирает их само. Дальше GCN-ядра выполняют вычисления, и готовый токен появляется на экране или озвучивается.
Собрано всё это на открытом тулчейне OpenOrbis для PS4. Отдельной головной болью было уместить модель с 9 миллиардами параметров в 8 ГБ памяти консоли, которую процессор делит с видеочипом.
При 8 битах на вес каждый параметр занимает байт, то есть модели нужно минимум 9 ГБ, а на практике ещё больше. Выход нашли в квантовании до 4 бит (Q4) – оно вдвое сокращает объём. А для двух самых крупных матриц в каждом слое применили ещё более агрессивное 3-битное квантование (Q3), которое вместе с масштабирующими коэффициентами даёт около 3,5 бита на вес.
В сумме модель ужимается примерно до 4,5 ГиБ – против 4,9 ГиБ у полностью 4-битного варианта. Кеш внимания, он же KV-кеш, тоже хранится в 4-битном формате, поэтому контекст на 16 тысяч токенов помещается, хотя нативный у модели – 256 тысяч. Итоговый расклад по памяти выглядит так:
Языковая модель Qwen3.5-9B – около 4,5 ГиБ
Модель диктовки Parakeet – 0,33 ГиБ
Голосовые модели Chatterbox – 0,29 ГиБ и 0,09 ГиБ
Общий объём – 5,23 ГиБ, или 5,62 ГБ
Цифра почти сходится с размером пакета в 5,66 ГБ. Остаток памяти съедают система, KV-кеш и само приложение.
Приличную для железа 2013 года скорость даёт модуль предсказания нескольких токенов (multi-token prediction, MTP), встроенный в Qwen3.5. С его помощью Garlic LLM набрасывает до двух токенов вперёд, а полная модель проверяет эти черновики. Модель изначально обучалась под такой режим – в инструкциях для vLLM на странице модели у Alibaba тоже указаны два спекулятивных токена.
С генерацией кода прирост ещё заметнее, скорость доходит до 43 токенов в секунду. Температура, то есть вариативность ответов, по умолчанию выставлена на 0,7. Alibaba рекомендует это значение для общих задач с выключенным режимом рассуждений и 1,0 с включённым. Впрочем, в демонстрационном ролике температура равна нулю – для предсказуемости вывода.

Разработчики Crimson Desert планирует внедрять ИИ на всех этапах разработки своих игр

Claude Fable 5.2 создала подводный мир весом 97 КБ, который выдает 180 FPS без игрового движка
На средней скорости в 35 токенов в секунду ответ длиной 300 токенов готовится меньше чем за девять секунд. Для сравнения, взломанная PS5 крутила втрое более крупную Qwen3.8-27B примерно на 20 токенах в секунду, а компактные Gemma 4 E4B и Llama 3.2 3B выдавали на ней 61 и 124 токена в секунду соответственно.
Эксплойтов в самом приложении нет, и консоль оно не взламывает. GoldHEN ставится на страх и риск пользователя, а Garlic LLM просто пользуется уже открытым доступом к железу – и превращает 13-летнюю PS4 в локального ИИ-ассистента с голосовым управлением.
- Моддер добавил в Skyrim полноценные порталы, но спорят все о Claude
- Minecraft-сервер на смартфоне с кулером от AMD и встроенным ИБП
- Эксперты объяснили, почему в Cyberpunk 2077 нельзя создать "добрый" ИИ, чтобы победить "злой"
Об авторе