Юрист собрал собственный ИИ-сервер из восьми старых Nvidia V100, чтобы не отправлять дела клиентов в облако

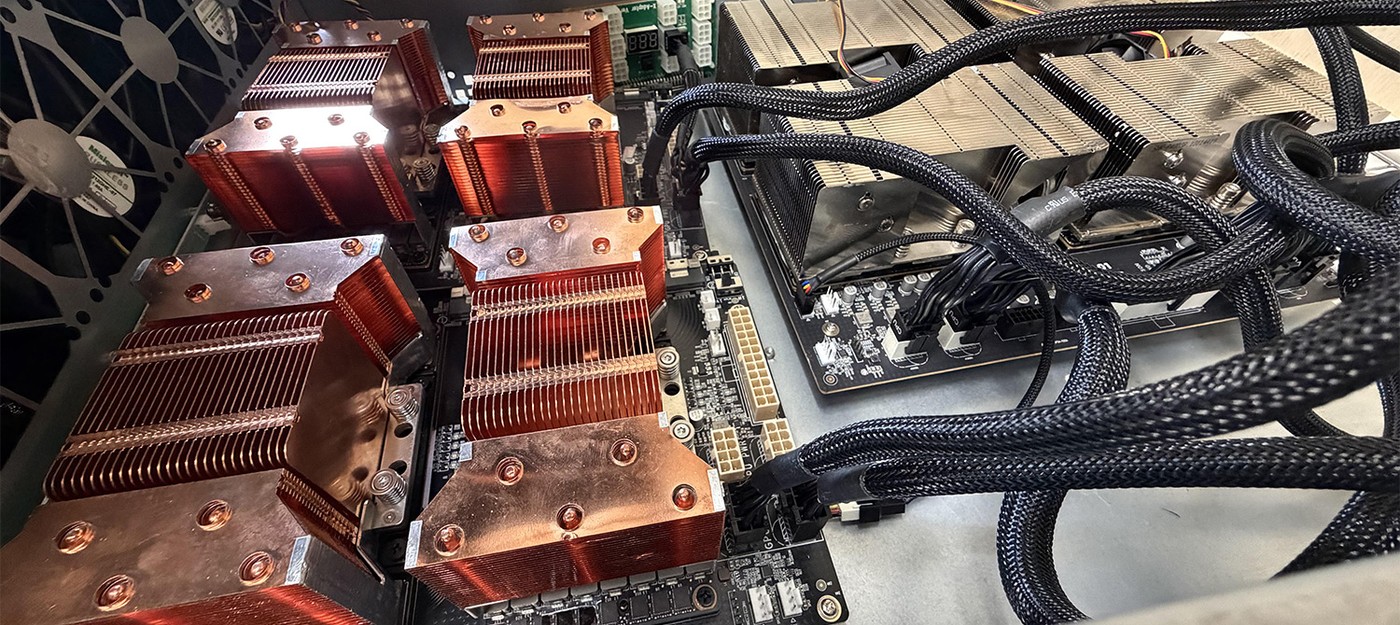
Практикующий юрист рассказал о частном ИИ-сервере, собранном из восьми подержанных серверных ускорителей Nvidia Tesla V100 2018 года. Цель простая – материалы дел не должны покидать офис. Сейчас система локально запускает открытую языковую модель DeepSeek V4.1 Flash. Все эксперты модели целиком размещены в видеопамяти, скорость генерации доходит до 215 токенов в секунду.
Основа сервера – две платы SXM2, на каждой по четыре ускорителя, объединённых через NVLink. Одна такая плата обошлась примерно в 2 400 долларов. Работа далась непросто: пришлось бороться со сбросами системы, ошибками памяти и даже обгоревшим разъёмом питания.
В сервере стоят восемь карт Tesla V100-SXM2-32GB на архитектуре Volta. У каждой 32 ГБ памяти HBM2 с пропускной способностью 900 ГБ/с. Карты вставляются не в привычные слоты PCIe, а в разъём SXM2, который Nvidia разработала для серверных ускорителей.
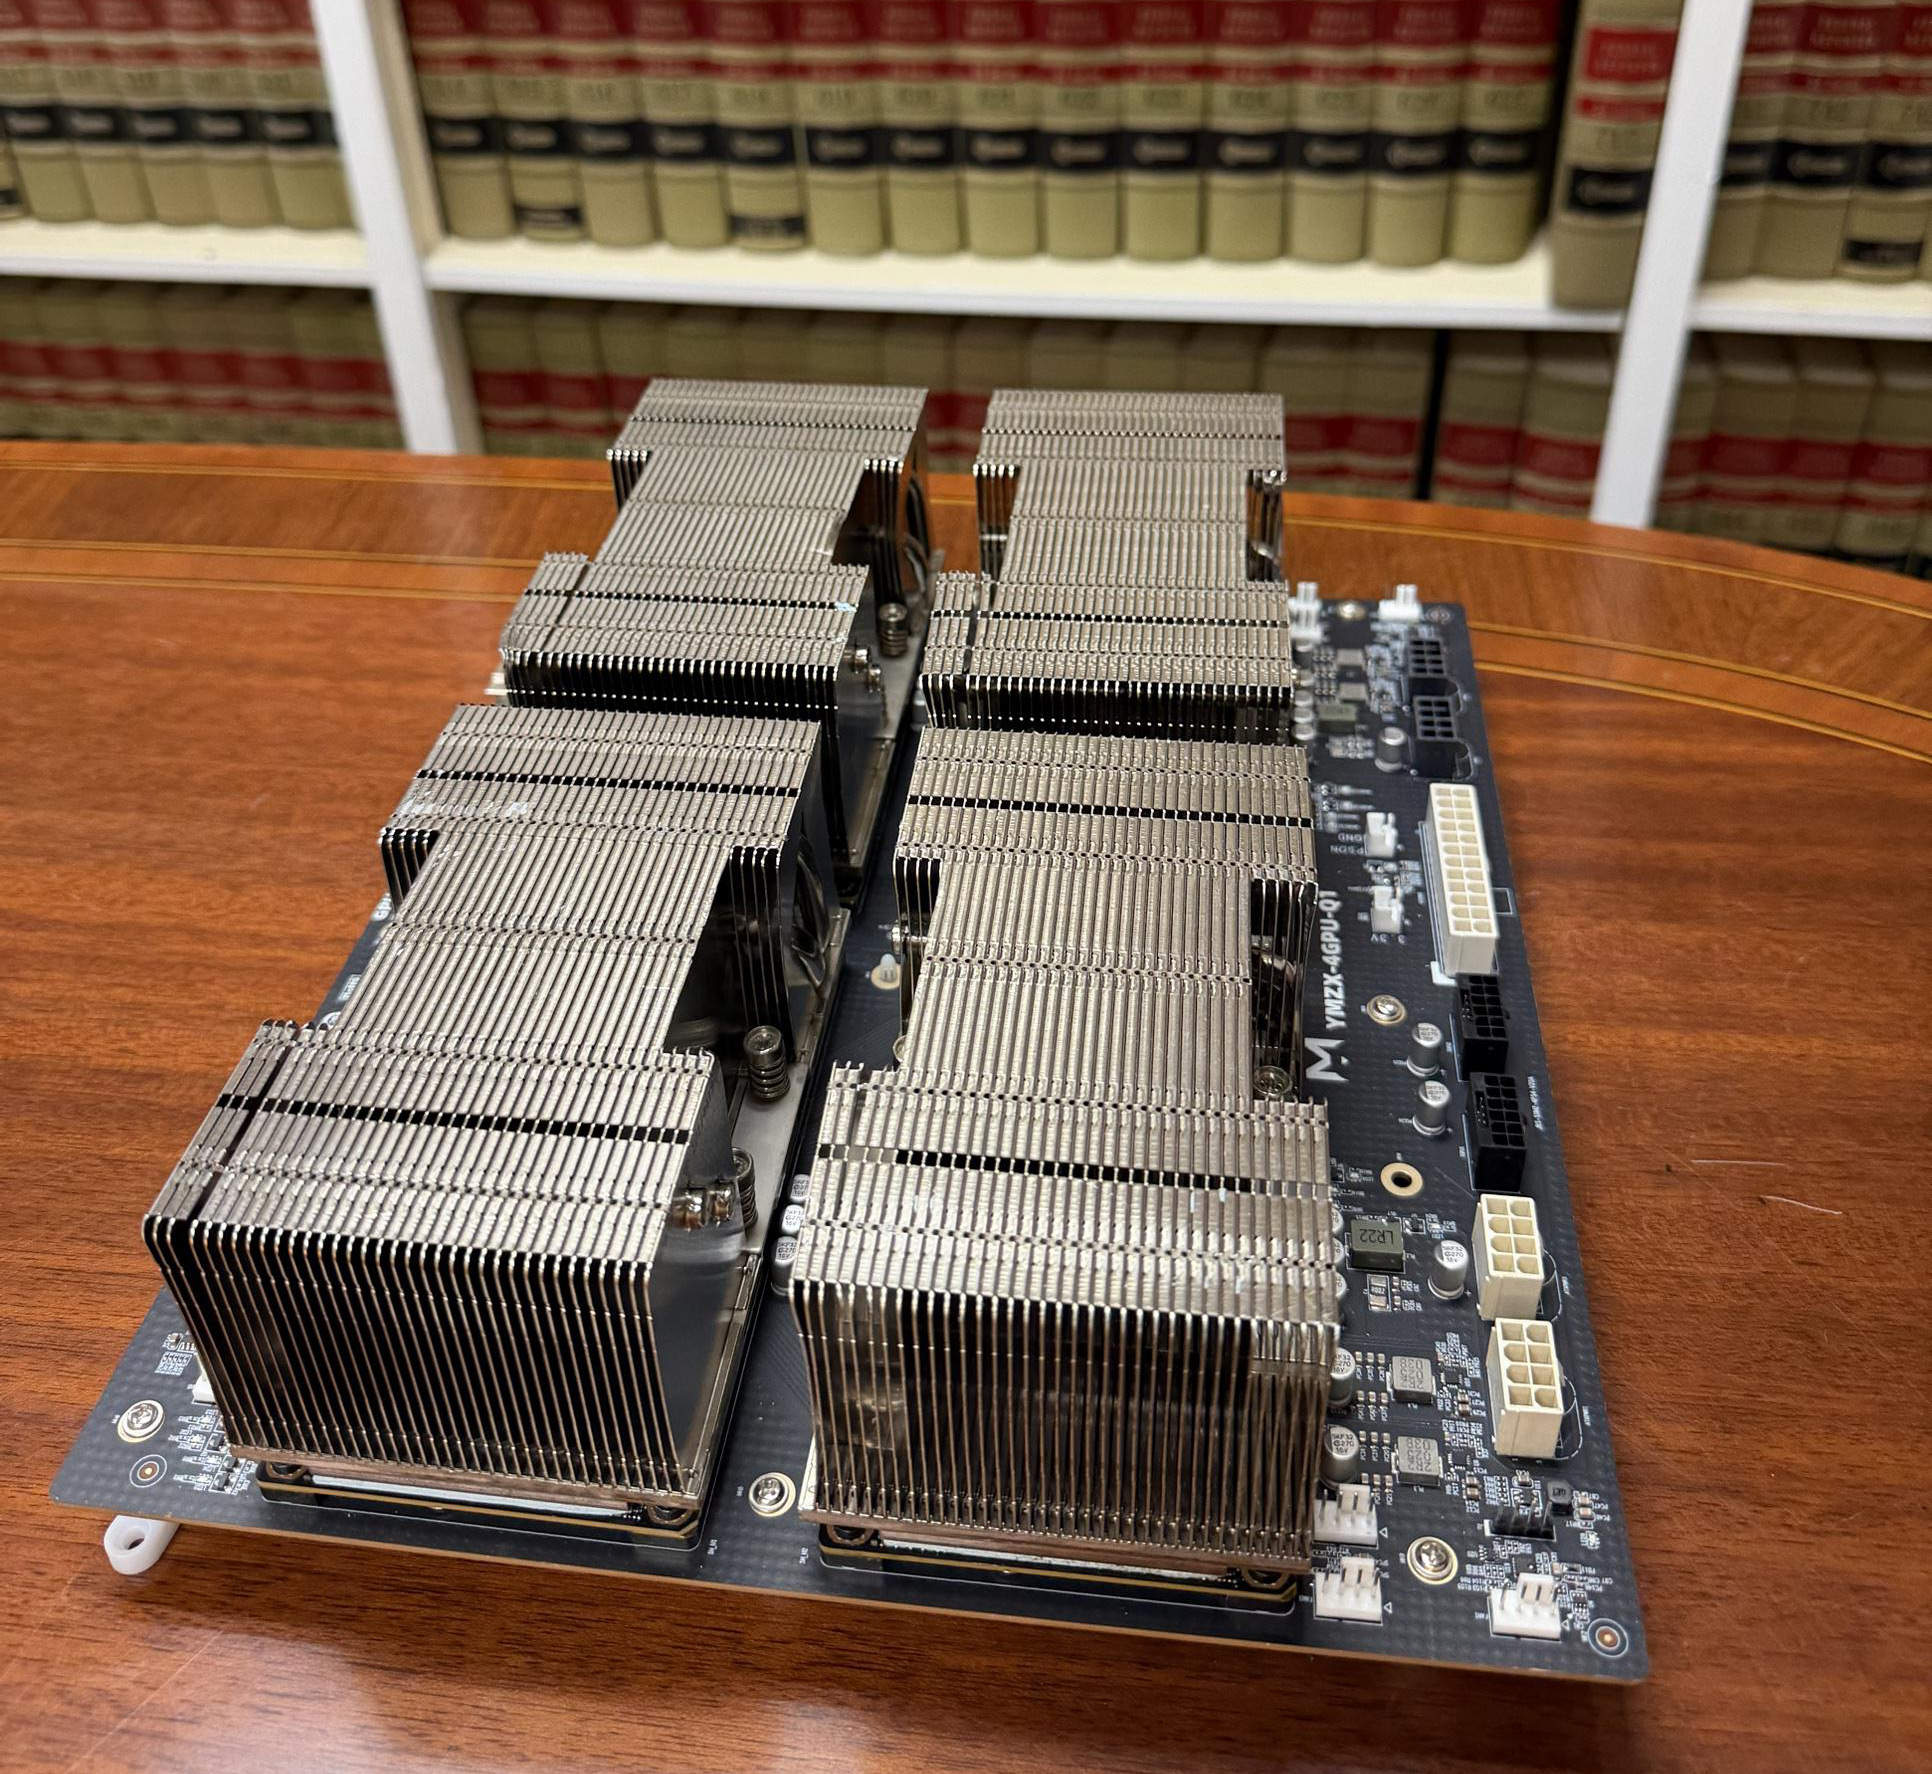
Внутри платы четыре карты связаны напрямую через NVLink – фирменный интерфейс Nvidia для обмена данными между GPU в обход процессора. На одной плате получается 128 ГБ быстрой видеопамяти. Между собой платы общаются только через PCIe, а это заметно более медленный канал.
К хост-системе каждая плата подключена через две карты-коммутатора PEX (PLX) по кабелям SlimSAS, всего коммутаторов четыре. Каждый обслуживает два GPU на скорости PCIe 3.0 x8 и имеет собственный восходящий канал x16. Остальная конфигурация выглядит так:
Материнская плата Gigabyte под Threadripper Pro
12-ядерный процессор AMD Threadripper Pro 3945WX
256 ГБ оперативной памяти DDR4 RDIMM (8 модулей по 32 ГБ) в одном узле NUMA
Два блока питания суммарной мощностью 2 800 Вт, подключённые к разным обычным офисным линиям электросети
По меркам сегодняшнего рынка сборка уже не выглядит дешёвой. В посте одна карта V100 SXM2 32GB стоила около 400 долларов, а сейчас на eBay их продают примерно за 900, и цены растут. При этом пример хорошо показывает, как списанное серверное железо позволяет собрать в одной машине большой объём быстрой видеопамяти за сравнительно небольшие деньги.
Сервер ежедневно используется для первичной обработки материалов дел. Модель читает папку с документами и извлекает из неё факты, даты и цифры, затем составляет краткие сводки и готовит черновики типовых документов. Юрист, при этом, отметил, что люди проверяют всё, что выдаёт система:
Ничего не уходит наружу без настоящей проверки.
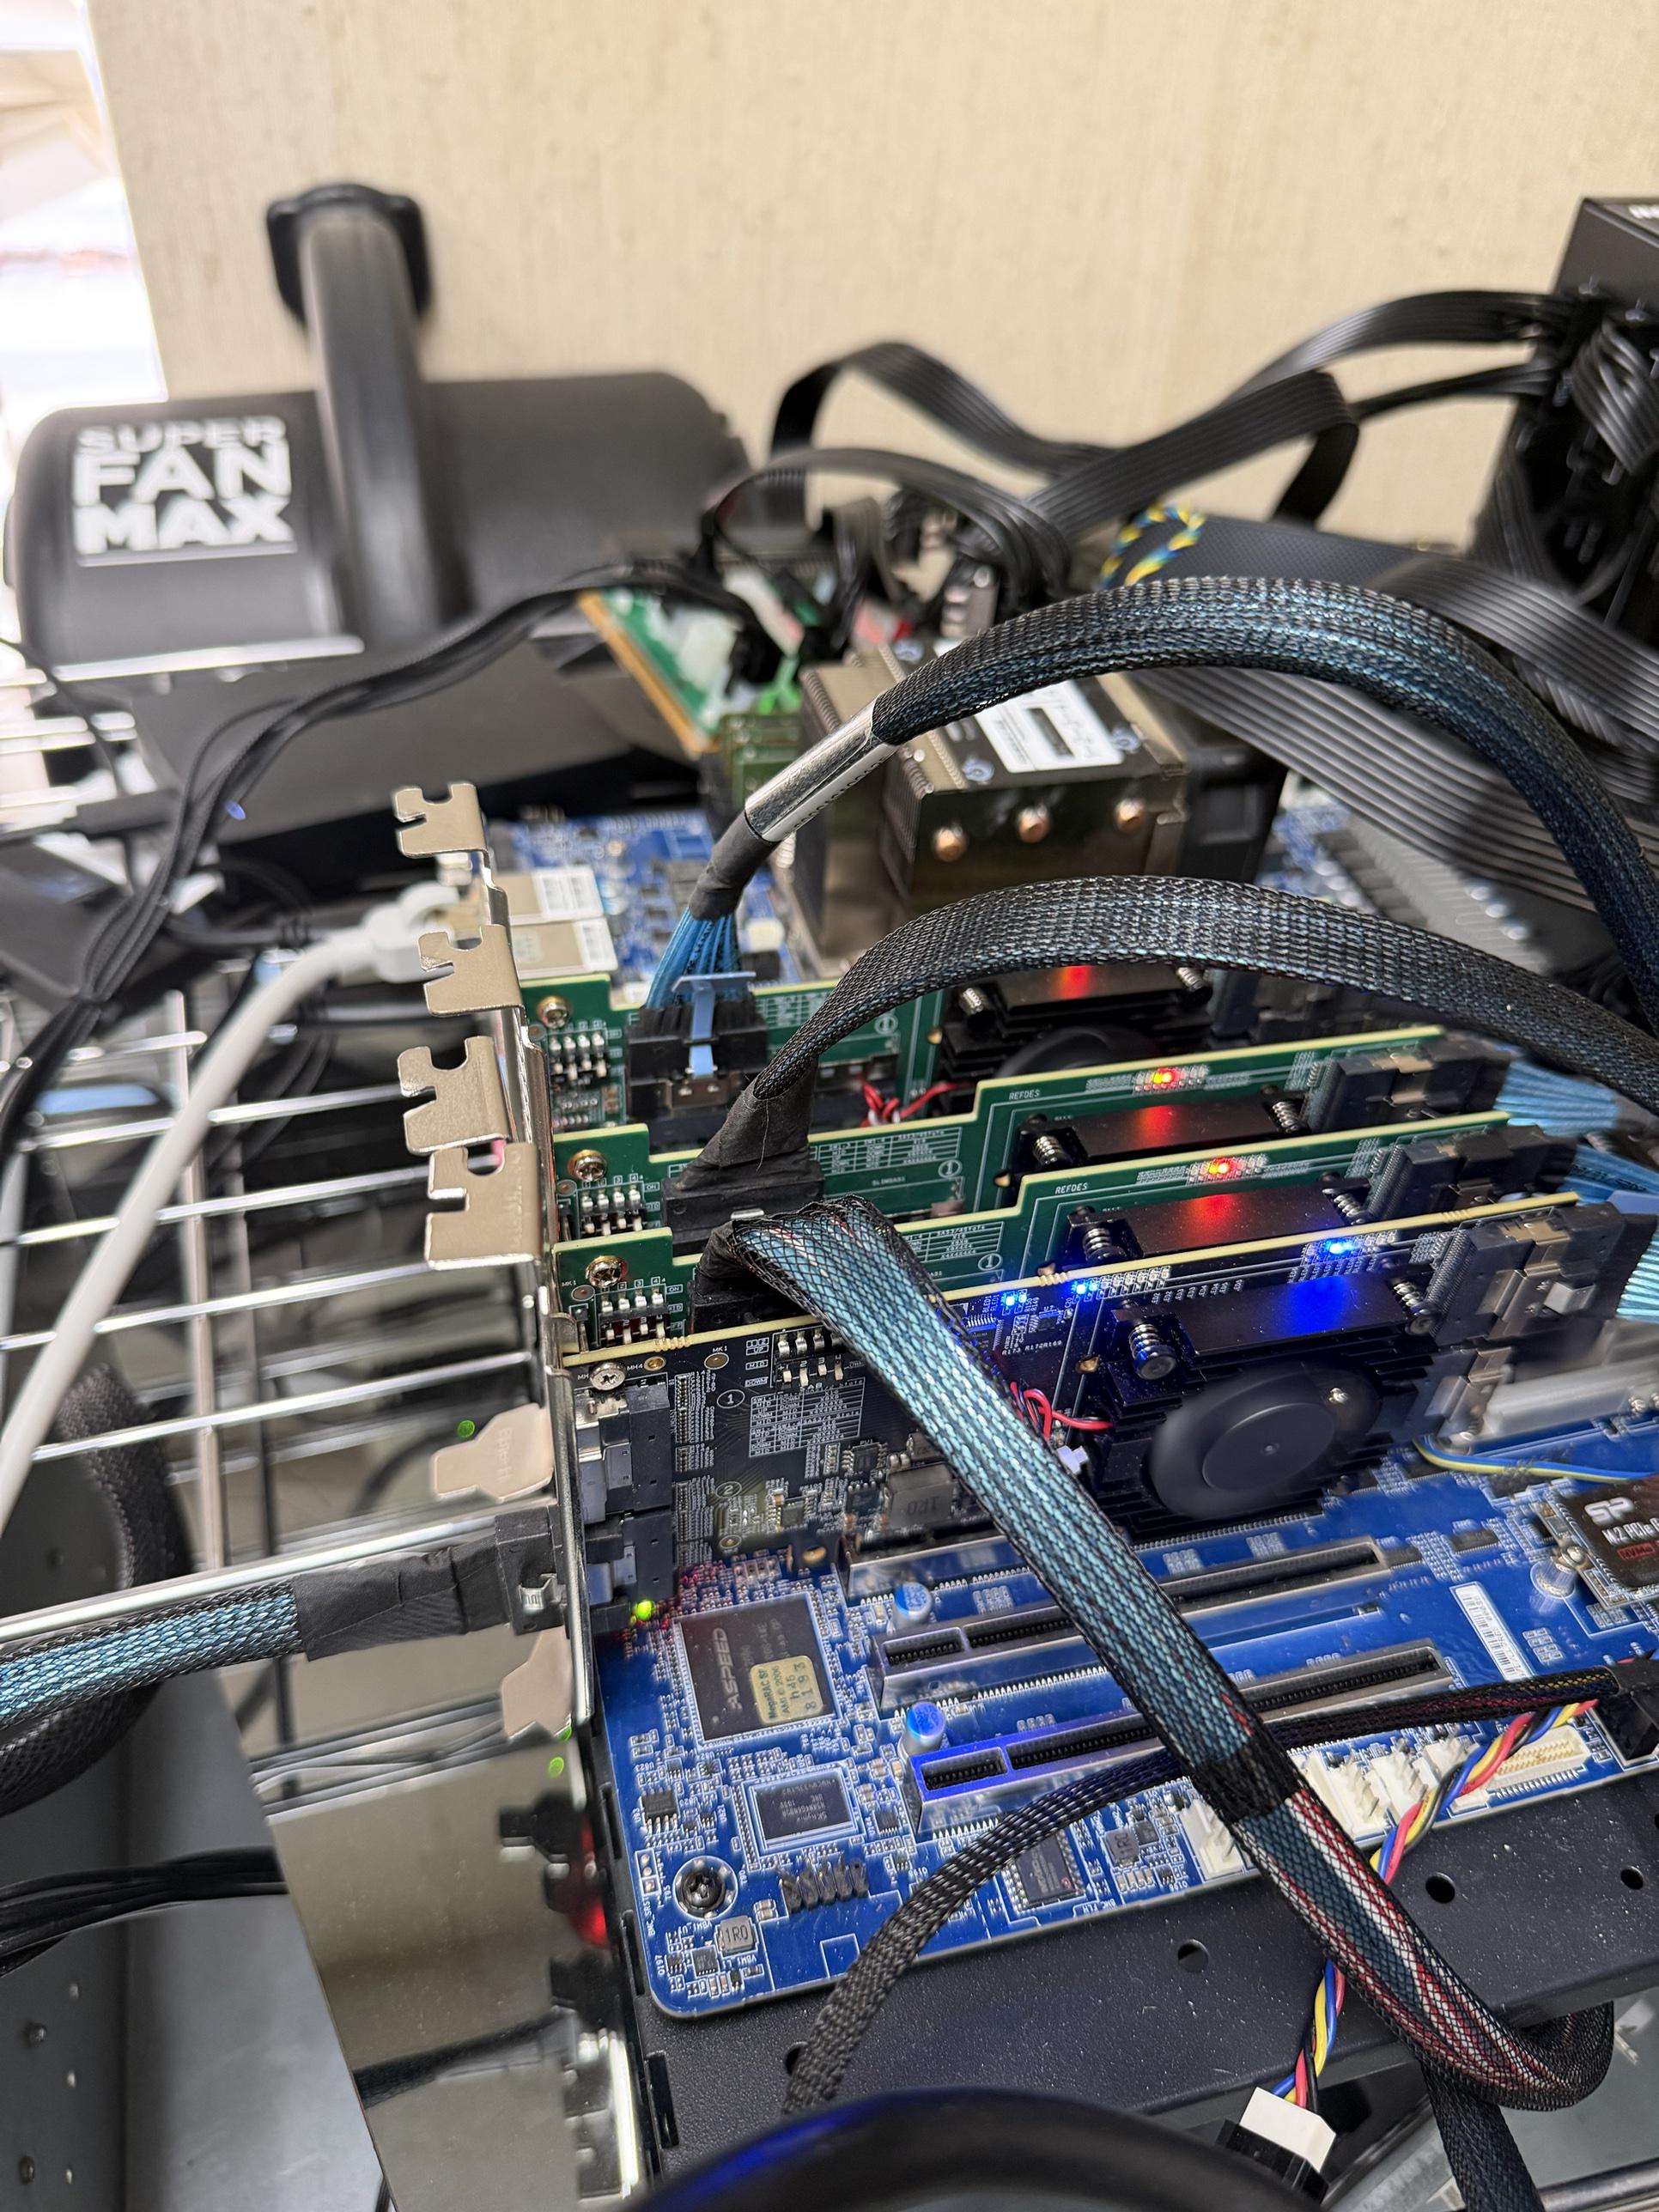
Локальный запуск решает и вопрос конфиденциальности – часть клиентских файлов нельзя передавать облачным сервисам и передовым коммерческим моделям. К системе подключены базы данных RAG (генерация с дополнением из внешних источников) и вызовы инструментов. Управлять сервером можно через интерфейс в стиле Discord по SSH, в данном случае с ПК на Windows. Пока система обрабатывает только один запрос за раз.
DeepSeek V4.1 Flash здесь сжата в основном до 2 бит, и даже так веса модели занимают 248,8 ГБ. Модель построена по схеме Mixture of Experts, где каждый токен обрабатывает лишь часть нейросети – так называемые эксперты. Все они хранятся в видеопамяти.
Ещё около 110 ГБ занимают таблицы поиска Engram, они лежат в обычной оперативной памяти. Обращение к ним занимает примерно 0,12 миллисекунды на шаг генерации. По словам сборщика, на итоговую скорость это почти не влияет.
Чтобы обойти узкое место в виде PCIe, слои модели разделены между платами. Слои с 0 по 19 работают на первой плате SXM2, слои с 20 по 39 – на второй. Основной трафик идёт внутри платы по NVLink, и через медленный PCIe за один шаг проходит лишь одна передача данных.
К такой схеме юрист пришёл не сразу. В одном из прошлых постов он описывал попытку распределить каждый слой сразу по всем восьми картам. Тогда из-за лишних переходов через PCIe скорость, по его словам, "упала в пропасть".
Для модели такого размера производительность получилась высокой. Быстрее всего генерируется код – до 215 токенов в секунду. Причина в спекулятивном декодировании: встроенная в DeepSeek небольшая черновая модель предсказывает пять токенов вперёд, а код с его повторяющимися конструкциями угадывается легко.
Юридические тексты, ради которых сервер и собирался, генерируются со скоростью до 118 токенов в секунду. С длинными документами есть задержка на старте. Входной запрос модель обрабатывает примерно со скоростью 2 200 токенов в секунду, так что при объёме 128 тысяч токенов первый токен ответа появляется примерно через минуту. Максимальное контекстное окно – 524 тысячи токенов.
За три дня до публикации та же модель на четырёх картах выдавала лишь 36–38 токенов в секунду. Часть прироста дала вторая плата, которая в идеальных условиях способна примерно удвоить производительность. Остальное объясняется собственными вычислительными ядрами и оптимизацией этапа предзаполнения.
Просто подключить всё и включить питание не вышло. Хост-система дважды перезагружалась с фатальной ошибкой PCIe на канале к одной из плат с GPU. Оба раза ускорители работали с повышенным лимитом мощности и без ограничения частот, карты потребляли 192–232 Вт при лимите в 180 Вт. Сборрщик предполагает, что во время скачков нагрузки одна из плат перестаёт отвечать, хотя проверить это пока не удалось.
Сбросы прекратились, когда юрист ограничил частоты и извлёк плату с подгоревшим разъёмом питания. Другим энтузиастам он посоветовал проверять свои разъёмы. Теперь каждая карта ограничена 150 Вт – половиной штатных 300 Вт, а частота графического ядра не превышает 1 522 МГц. Тесты показали, что лимит в 200 Вт заметного прироста скорости не даёт.
Проблемы возникли и с оперативной памятью. Система фиксировала неисправимые ошибки ECC, которые исчезли после снижения частоты с DDR4-3200 до DDR4-2666. Кроме того, при последней проверке один GPU работал в режиме x4 вместо x8. Юрист планирует переустановить карту, а один из комментаторов рассказал, что у него похожая проблема с V100 возникала из-за неисправного кабеля.
По оценке, усилия окупились – 50–60% его рабочих задач с языковыми моделями теперь выполняются на собственном сервере, а не на облачных моделях. Рядом работает второй сервер с DeepSeek на двух Nvidia DGX Spark, системы передают задачи друг другу. В сравнении с оплатой API такая схема экономит деньги, хотя, по словам юриста, быстрее она не стала.

Критики Сэма Альтмана шутят, что тот скоро начнет использовать людей в качестве батареек – прямо как в "Матрице"

Грабители увели груз Nvidia на 11,4 миллиона долларов – такие кражи происходят всё чаще
Главная цель связана с защитой клиентских данных. Полную конфиденциальность сервер обеспечит, когда станет полностью автономным, и именно к этому юрист стремится. В будущем V100-сервер может получить отдельную линию на 240 В.
Есть и ограничение по срокам. Ветка драйверов Nvidia R580 стала последней с поддержкой архитектуры Volta, так что новых оптимизаций для этих карт ждать не стоит. Следующий шаг – одновременная обработка двух-трёх запросов. Эту функцию уже собрали и проверили на тестовой системе, но на основной сервер пока не перенесли.
На вопрос, не проще ли для задач использовать обычные программы для работы с базами данных, юрист ответил, что движется к полностью офлайновой локальной системе, которая может быть востребована в регулируемых профессиях, не только в юриспруденции. Пока же задача в том, чтобы по возможности сократить расход токенов передовых моделей. Сам он признаёт, что настройка этого железа стала для него увлекательным хобби, которое со временем может превратиться в бизнес-идею.
- Стартап платит пользователям за поиск нарушений авторских прав в ChatGPT и других чат-ботах
- OpenAI уволила вице-президента по безопасности из-за сексуальной дискриминации мужчин – сама она считает, что дело в разногласиях по поводу взрослого режима ChatGPT
- Ветеран BioWare с опытом работы над Mass Effect присоединился к разработке The Witcher 4 в качестве ИИ-директора
Об авторе